Пересказ статьи Mehdi Ghapanvari. SQL Server Concurrency Issues with Parallel Query Plans
Параллелизм может уменьшить способность одновременного выполнения запросов. Это веская причина не позволять SQL Server агрессивно выполнять запросы в параллельном режиме. В этом совете я создам демонстрацию, чтобы показать, что параллелизм снижает производительность запросов на сервере с высоким уровнем конкуренции.
Параллелизм позволяет SQL Server выполнять запросы на нескольких ядрах ЦП одновременно. Оптимизатор запросов определяет, стоит ли выполнять запрос параллельно или нет на основании стоимости. Если запрос сложный, содержит дорогие операции (такие как сортировка, группировка и т.п.) и обрабатывает много строк, то это с большей вероятностью приведет к параллельному плану, чем простой запрос, который обрабатывает несколько строк.
Continue reading "Проблемы параллелизма SQL Server с планами одновременно выполняющихся запросов"
Пересказ статьи Arvind Toorpu. Optimizing Data Loader Jobs in SQL Server: Production Implementation Strategies
За последние 15 лет, работая с SQL Server в различных областях, я видел, что производительность загрузки данных по-прежнему остается одной из наиболее важных - и очень часто недооцененных областей в администрировании баз данных. Являются ли они ночными загрузками миллионов транзакций, интеграцией данных из множества источников или перемещением терабайтов данных между средами, неэффективная обработка загрузки быстро приводит расползанию проблем: пропущенные соглашения об уровне обслуживания, увеличение размера окон обслуживания, устаревшие отчеты и растущее недовольство как пользователей, так и руководства.
На самом деле SQL Server предоставляет надежный набор функций и инструментов, которые могут в значительной степени улучшить производительность загрузки данных при правильном использовании. Я применял эти методы в сфере финансовых услуг, здравоохранения, розничной торговли и производства, постоянно добиваясь повышения производительности от трех до десяти раз. В следующем разделе я пройдусь по практическим, протестированным в рабочей среде подходам ускорения загрузки данных. Сделайте их надежной частью вашей платформы данных.
 Continue reading "Оптимизация заданий загрузки данных в SQL Server: стратегии реализации в рабочей среде"
Пересказ статьи Paul Ramsey. Postgres JSONB Columns and TOAST: A Performance Guide
PostgreSQL имеет большой набор функций, ориентированных на пользователя, которые работают в самых разных случаях использования — со сложной абстракцией под капотом.
Работа с API и массивами с типом данных jsonb становится все более популярной в настоящее время, и хранение фрагментов данных приложения с использованием jsonb становится общим шаблоном проектирования.
Но зачем разбивать объект JSON на строки и столбцы, а затем восстанавливать его позже, чтобы отправить обратно клиенту?
Ответом является эффективность. PostgreSQL наиболее эффективен при работе со строками и столбцами, и сокрытие структуры данных внутри JSON не позволяет движку работать так быстро, как он мог бы.
Continue reading "Столбцы JSONB и TOAST в Postgres: пособие по производительности"
Пересказ статьи Jeyaram Ayyalusamy. PostgreSQL 17 Performance Tuning: Creating Tables, Populating 10M Records, and Detecting Unused Indexes
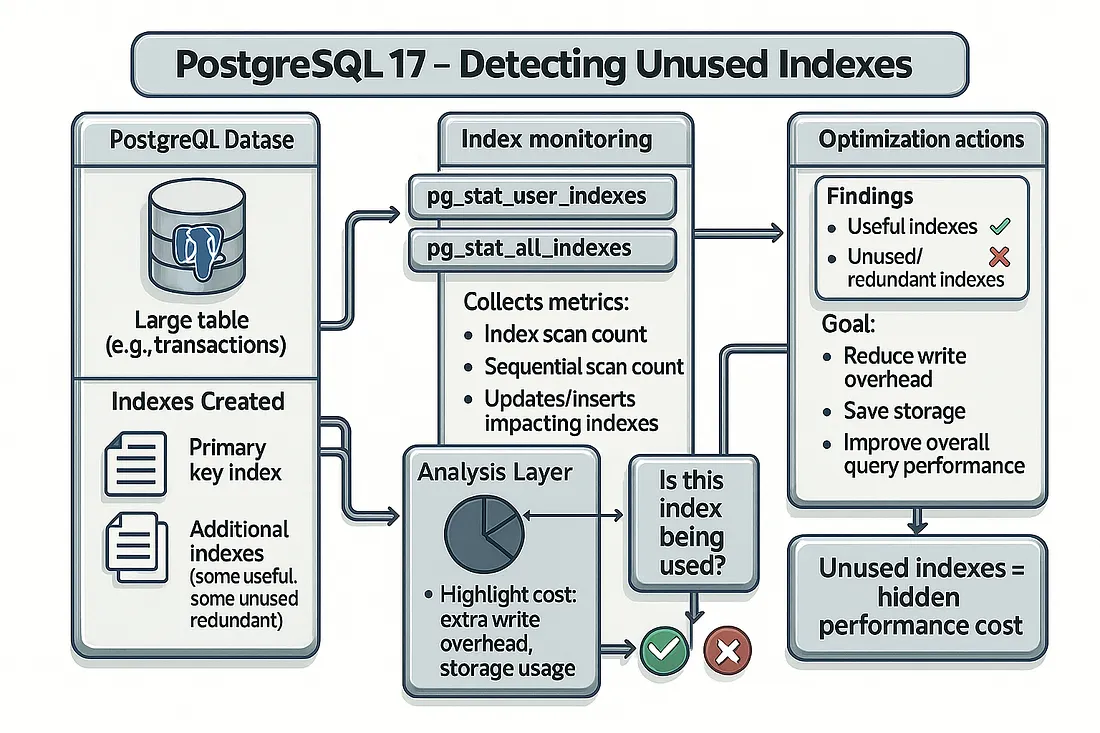
При настройке PostgreSQL большинство разработчиков и администраторов баз данных сосредотачиваются на поиске отсутствующих индексов, чтобы ускорить запросы. Это важный этап, но есть другая сторона медали: иногда вам требуется обнаружить индексы, которых вообще не следует иметь.
Неиспользуемые или избыточные индексы часто упускаются из виду, хотя они могут незаметно снижать производительность системы. В этой статье мы узнаем, почему это происходит, и на практическом примере создания большого набора данных и построения индексов проанализируем, какие из них действительно полезны.
Continue reading "Настройка производительности в PostgreSQL 17: создание таблиц, вставка 10М записей и обнаружение неиспользуемых индексов"